一句話直答:RAG(Retrieval-Augmented Generation,檢索增強生成)的做法,是先把你的資料切成小塊、轉成向量存進索引,提問時先檢索出最相關的幾段,再把它們塞進提示詞,讓模型只根據這些段落作答。它不改模型本身,只是在回答前把「查得到的根據」餵進去,所以能明顯降低亂編,也比較容易標出處。2026 年要做出可用的 RAG,關鍵已經不是會不會接,而是切塊、檢索、重排這三段調得好不好。
以下從架構講到最小可行實作,關鍵段落都配圖對照,最後收在常見失敗模式與 FAQ。
RAG 是什麼?先把三個名詞拆開看
RAG 在 2020 年由 Facebook AI 的論文提出,核心精神是把「模型記在參數裡的知識」與「放在外部、隨時可換的資料」分開。名字裡的三個字就是它的三步:
- Retrieval 檢索:把問題拿去比對你的資料,挑出最相關的段落。
- Augmented 增強:把挑出來的段落接到提示詞裡,成為這次回答的臨時上下文。
- Generation 生成:模型看著這些段落寫答案,而不是憑記憶寫。
它跟「把整份文件直接塞進上下文」最大的差別在規模與更新速度。整份塞的做法在幾十頁以內很好用,但資料變成幾千份文件時,你不可能每問一次就送幾百萬個 token 進去。RAG 把「送什麼進去」變成一道可調的檢索問題,資料更新時只要重建索引,不必重訓模型。如果你還在挑模型與上下文規格,可以對照 大模型 API 怎麼挑?價格、上下文、工具呼叫比較(2026) 一起看。
RAG 的五步管線
實務上的標準架構分成兩個階段:索引階段離線做一次,查詢階段每次提問都跑。調校的順序建議照管線走,先確認切塊品質,再處理檢索,最後才加值重排。
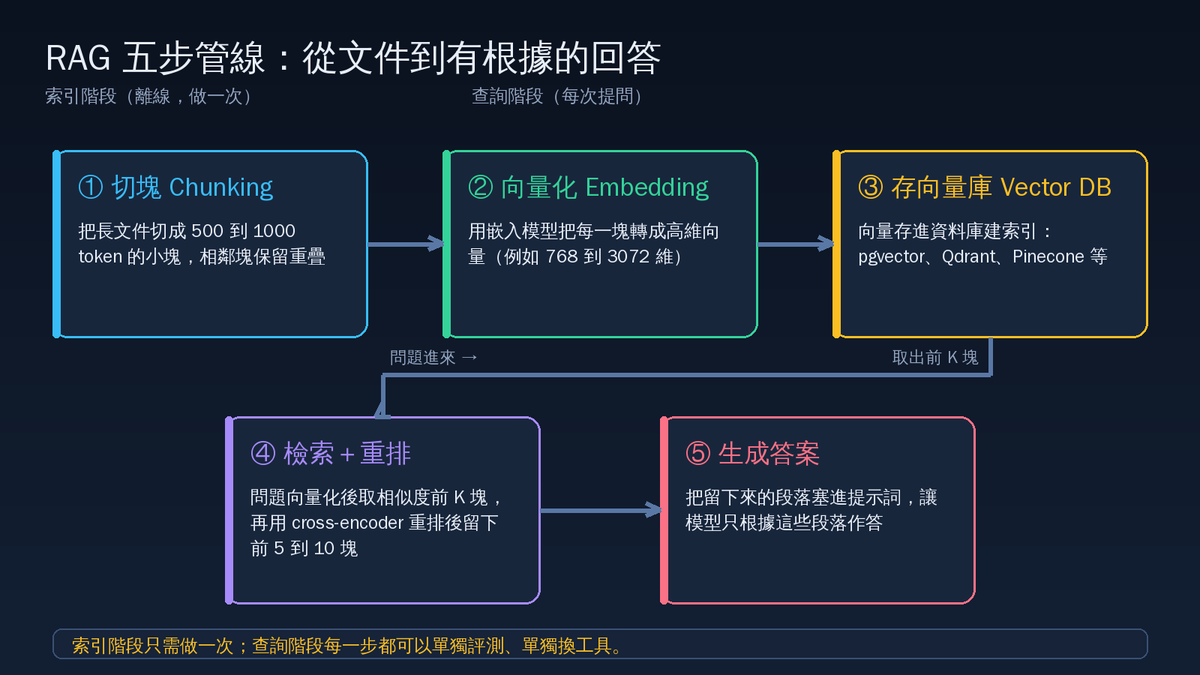
- 切塊 Chunking:長文件切成約 500 到 1000 token 的小塊,相鄰塊保留 10 到 20% 重疊,避免一句話被切斷。
- 向量化 Embedding:用嵌入模型把每一塊轉成高維向量,常見維度是 768 到 3072 維。
- 存向量庫 Vector DB:向量連同原文與來源資訊寫進資料庫並建立索引。
- 檢索與重排:問題同樣轉成向量,先取相似度前 K 塊(實務常見 K 在 50 到 100 之間),再用重排模型挑出真正要送進提示詞的前 5 到 10 塊。
- 生成答案:把留下的段落連同問題送進模型,並在提示詞裡要求「只根據以下段落作答,找不到就說不知道」。
有一個容易忽略的環節是混合檢索。純向量檢索對專有名詞、產品編號、罕見縮寫比較弱,把關鍵字檢索(BM25)加進來,再用 RRF 之類的方法合併分數,通常會比純向量穩。Anthropic 官方部落格曾公布,加入上下文檢索後檢索失敗率約降低 49%,再疊上重排可降低約 67%(數字來自官方部落格,最新數據以官網文件為準)。
Chunking 策略怎麼選?四種切法對照
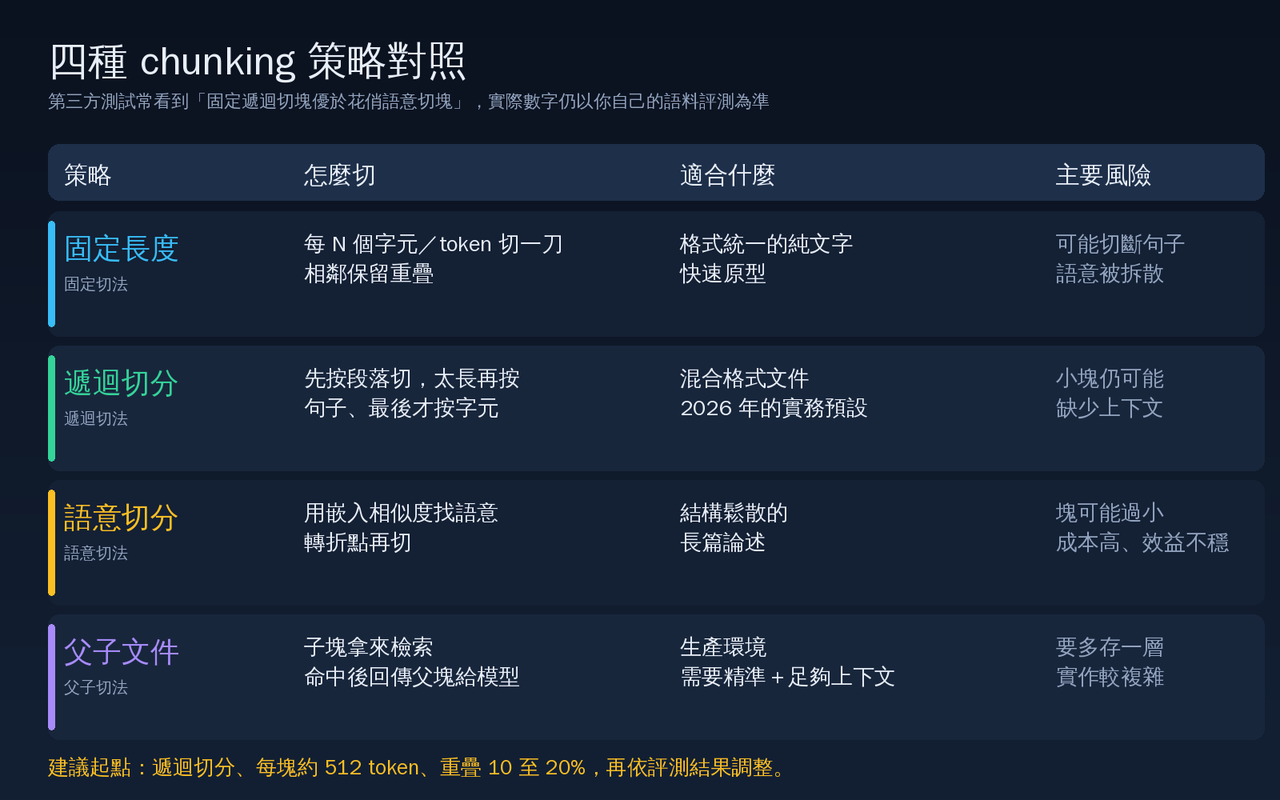
切塊是 RAG 裡投報率最高的一段,也是最常被跳過的一段。常見四種做法與取捨如下:
| 策略 | 怎麼切 | 適合什麼 | 主要風險 |
|---|---|---|---|
| 固定長度 | 每 N 個字元或 token 切一刀,相鄰保留重疊 | 格式統一的純文字、快速原型 | 可能切斷句子,語意被拆散 |
| 遞迴切分 | 先按段落切,太長再按句子,最後才按字元 | 混合格式文件,2026 年的實務預設 | 小塊仍可能缺少上下文 |
| 語意切分 | 用嵌入相似度找語意轉折點再切 | 結構鬆散的長篇論述 | 塊可能過小、成本高、效益不穩 |
| 父子文件 | 子塊拿來檢索,命中後回傳父塊給模型 | 生產環境,要同時顧精準與上下文 | 要多存一層,實作較複雜 |
第三方部落格的比較測試常看到「固定遞迴切塊勝過花俏的語意切塊」,有測試結果是 69% 對 54%,但這類數字高度依賴語料與題目設計,建議用自己的文件跑評測再定案。
務實的起點:遞迴切分,每塊約 512 token,重疊 10 到 20%,準備 100 到 200 題人工標註的問題集來量命中率。
嵌入模型與向量庫:2026 年的選項
嵌入模型負責把文字變成可比較的座標,向量庫負責快速找出最近的鄰居。兩者都可以先選簡單的,之後再換。
| 元件 | 常見選項 | 選擇要點 |
|---|---|---|
| 嵌入模型 | OpenAI text-embedding-3 系列、Gemini Embedding、Voyage 系列、開源的 BGE-M3、nomic-embed-text | 挑與你的語言相符、且在 MTEB 榜上有穩定表現的;維度不是越高越好,成本與記憶體會同步上升。 |
| 向量庫 | pgvector、Qdrant、Weaviate、Milvus、Chroma、Pinecone | 已經有 PostgreSQL 就先用 pgvector,少一套系統要顧;託管服務省維運,但按量計費。 |
| 檢索方式 | 純向量、BM25 關鍵字、混合檢索(RRF 合併分數) | 語料含大量專有名詞、型號或編號時,務必上混合檢索。 |
| 重排模型 | Cohere Rerank、開源的 bge-reranker 系列 | 只在候選的 50 到 100 塊上跑,成本可控,通常是加值最高的一段。 |
| 框架 | LangChain、LlamaIndex、Haystack;雲端有 Bedrock Knowledge Bases、Azure AI Search 等 | 框架幫你省接線,但除錯時要知道它背後做了什麼,否則失敗模式很難追。 |
規模判斷:幾千塊以內,用 numpy 直接算相似度就夠;到十萬塊以上再認真考慮專用向量庫與 HNSW 之類的近似索引。各專案的參數與支援範圍,一律以官網文件為準。
該用 RAG、微調,還是長上下文?
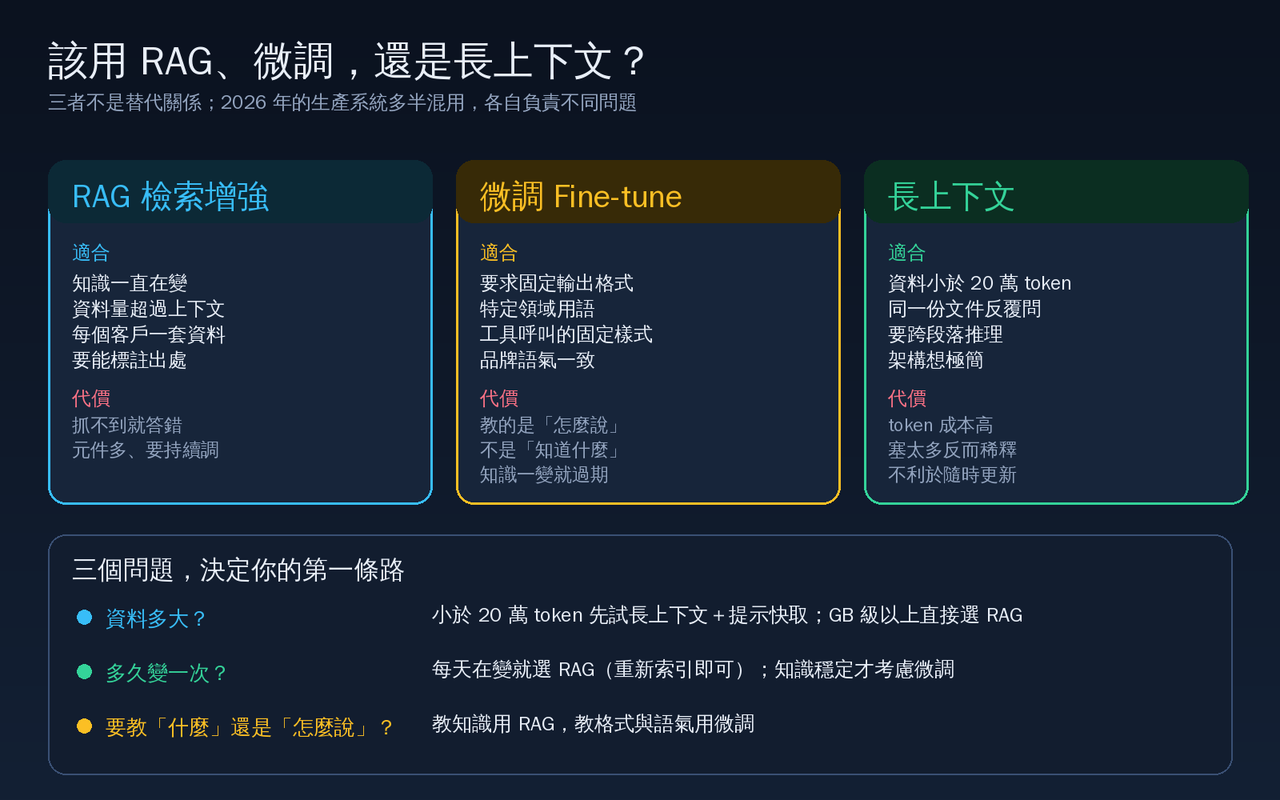
這三者不是替代關係,2026 年的生產系統多半混用。一句話分界:RAG 負責「知道什麼」,微調負責「怎麼說」,長上下文負責「這次要看多少」。
| 面向 | RAG | 微調 | 長上下文 |
|---|---|---|---|
| 適合 | 知識常變、資料量大、要標出處 | 固定格式、語氣、工具呼叫樣式 | 語料小、同一份文件反覆問 |
| 更新方式 | 重建索引即可 | 要重新訓練,知識會過期 | 每次換文件即更新 |
| 成本結構 | 一次性嵌入加索引維運 | 訓練成本加推論成本 | 每次提問的 token 費用最高 |
| 能否標出處 | 可以,逐段對回原文 | 通常不行 | 可以,但檔案長時不好定位 |
| 最大風險 | 檢索抓不到就答錯 | 學不到新知識,容易答錯 | 塞太多反而稀釋重點 |
實務建議:資料量小於 20 萬 token,先用長上下文加提示快取驗證需求;知識每天在變、資料量在 GB 級以上、需要標註出處,就直接選 RAG。微調留給格式、語氣、固定工具呼叫樣式這類行為問題。想在本地環境跑整條管線的話,可以參考 本地部署大模型 的機器規格與取捨。
30 分鐘最小可行 RAG
要驗證想法,不需要一開始就架向量庫。用一份文件、一個開源嵌入模型、幾行程式就能跑完整條管線,先確認檢索準不準,再投資基礎設施。
- 把文件轉成純文字,用遞迴切分切成約 500 token 的段落,存成清單。
- 用嵌入模型把每個段落轉成向量。
- 把問題也轉成向量,算餘弦相似度,取前 5 名。
- 把前 5 名塞進提示詞,要求模型只根據這些段落作答。
# pip install sentence-transformers
from sentence_transformers import SentenceTransformer

docs = ["第一段文字", "第二段文字", "..."]
model = SentenceTransformer("BAAI/bge-m3")
doc_vecs = model.encode(docs, normalize_embeddings=True)

def retrieve(query, k=5):
    q = model.encode([query], normalize_embeddings=True)[0]
    scores = doc_vecs @ q                      # 已正規化,內積等於餘弦相似度
    order = scores.argsort()[::-1][:k]
    return [(docs[i], float(scores[i])) for i in order]

hits = retrieve("退貨政策幾天內可以申請?")
prompt = "只根據以下段落回答,找不到就說不知道。\n\n" + "\n\n".join(d for d, _ in hits)
這套做法在幾千塊以內完全夠用。超過之後把 doc_vecs 換成 pgvector 或 Qdrant 的檢索呼叫,其餘邏輯不用改。要再進一步,就把第 3 步改成先取前 50 塊,再交給重排模型篩出前 5 到 10 塊。
常見失敗模式與對應修法
| 症狀 | 真正的原因 | 修法 |
|---|---|---|
| 答案亂編 | 檢索沒撈到相關段落,模型只好自己補 | 先量檢索命中率,補上「找不到就說不知道」與引用要求,必要時加混合檢索 |
| 撈到段落但答案還是錯 | 段落被切斷,關鍵條件落在別的塊 | 提高重疊比例,或改用父子文件(子塊檢索、回傳父塊) |
| 專有名詞查不到 | 純向量檢索對罕見字串不敏感 | 加入 BM25 關鍵字檢索並用 RRF 合併分數 |
| 相似度分數都很高 | 嵌入模型與語料不匹配,或向量未正規化 | 換模型並正規化向量,改以重排分數當最終排序依據 |
| 上線後品質慢慢下滑 | 沒有評測,改了也不知道變好還變差 | 建立 100 到 200 題的固定問題集,每次改動都回歸測試 |
最後一項最關鍵。RAG 的品質是切塊、檢索、生成三個環節相乘的結果,單靠直覺常常判斷錯,一定要有問題集才能調。
常見問題 FAQ
RAG 一定要搭配微調嗎?
不需要。大多數「回答不準」的問題出在檢索,不在模型。先把切塊與檢索調好,比急著微調有效得多。只有在你要固定輸出格式或特定語氣時,微調才值得投入。
一定要用向量資料庫嗎?
不必。幾千塊以內用 numpy 或 SQLite 直接算相似度就好;已經有 PostgreSQL 就用 pgvector。資料到十萬塊以上,或需要混合檢索與多租戶隔離時,再換專用向量庫。
chunk 要切多大?
從 512 token、重疊 10 到 20% 起步,再用自己的問題集微調。切太小會缺上下文,切太大會讓不相關內容稀釋訊號,檢索精度反而下降。
RAG 跟 MCP 有什麼關係?
兩者解決的問題不同。RAG 是檢索與組裝上下文的方法,MCP 是模型與外部工具、資源之間的標準介面。MCP 的 resources 可以把一份文件或一個資料庫端點暴露給模型,但要不要切塊、要不要做向量檢索,仍然是你自己決定的 RAG 設計。細節可看 MCP 圖解入門。
RAG 的成本怎麼估?
一次性成本主要在嵌入全部文件與維運向量索引,持續成本是每次提問的嵌入與生成 token。自建與訂閱制 API 的攤提差異,可以對照 AI 訂閱費怎麼算? 的算法一起比較。
中小團隊最簡單的起步方式?
先做一個內部問答機器人,語料放 20 到 50 份最常被問到的文件,跑上面的最小可行流程,用真實同事的問題當測試集。命中率超過八成就值得投資向量庫與重排。