Function calling(函式呼叫,也常叫 tool calling/工具呼叫)是讓大型語言模型跳出「只會聊天」的關鍵機制:你把可用的工具用 JSON Schema 描述清楚,模型在需要時回傳一段結構化的呼叫請求(工具名稱加上參數),但真正執行的那段程式永遠是你的程式碼。模型自己不會碰到你的資料庫,也不會碰到你的 API 金鑰。看懂這一句,就等於看懂了 2026 年所有 AI 代理(agent)的底層。
這篇用四張圖把整個流程拆開:先界定 function calling 的邊界,再看四步循環、工具定義、Python 實作,接著釐清它和 MCP 的關係,最後把最常踩的五種錯誤與重試做法收成一張表。如果你對大模型本身還不熟,可以先看 大模型是什麼?2026 最新白話入門與選型重點。
Function Calling 是什麼?先把邊界畫清楚
OpenAI 的官方文件把 function calling(也稱 tool calling)定義成「模型與外部系統、以及模型訓練資料之外資料之間的介面」;Anthropic 稱之為 tool use,Google Gemini 則叫 function calling。三家的共同點是:應用程式在請求裡附上工具定義,模型可以選擇正常用文字回答,也可以回傳一個結構化的工具請求,由應用程式執行後把結果送回模型。
這裡有三個很容易混在一起、但必須分開的概念,OpenAI 的文件分得很清楚:
- 工具(tool/function):你告訴模型「你手上有哪些功能可以用」,內容包含名稱、描述與參數的 JSON Schema。
- 工具呼叫(tool call):模型看完提示後,判斷需要某個工具,於是回傳的一段結構化資料。它只是一段「請求」,不是執行結果。
- 工具輸出(tool output):你的程式依照呼叫內容執行程式碼之後產生的結果,再送回模型。可以是結構化 JSON,也可以是圖片或檔案。
所以「模型呼叫了函式」只是一種方便的說法。實際上模型只發出意圖;驗證參數、檢查權限、執行、處理逾時與錯誤、決定要不要把結果回饋給模型,全部由應用程式負責。三家供應商對同一件事的用字不同,欄位名稱也不一樣,動手前先對一下:
| 供應商/協定 | 對外名稱 | 參數欄位名 | 呼叫物件長什麼樣 |
|---|---|---|---|
| OpenAI | function calling/tool calling | parameters | 回應裡的 tool call 項目,帶 call_id 與 arguments |
| Anthropic | tool use | input_schema | content 陣列裡的 tool_use 區塊,帶 id 與 input |
| Google Gemini | function calling | parameters | functionCall 物件,帶 name 與 args |
| MCP | tools | inputSchema | JSON-RPC 的 tools/call 請求 |
四步流程:模型負責選,你的程式負責做
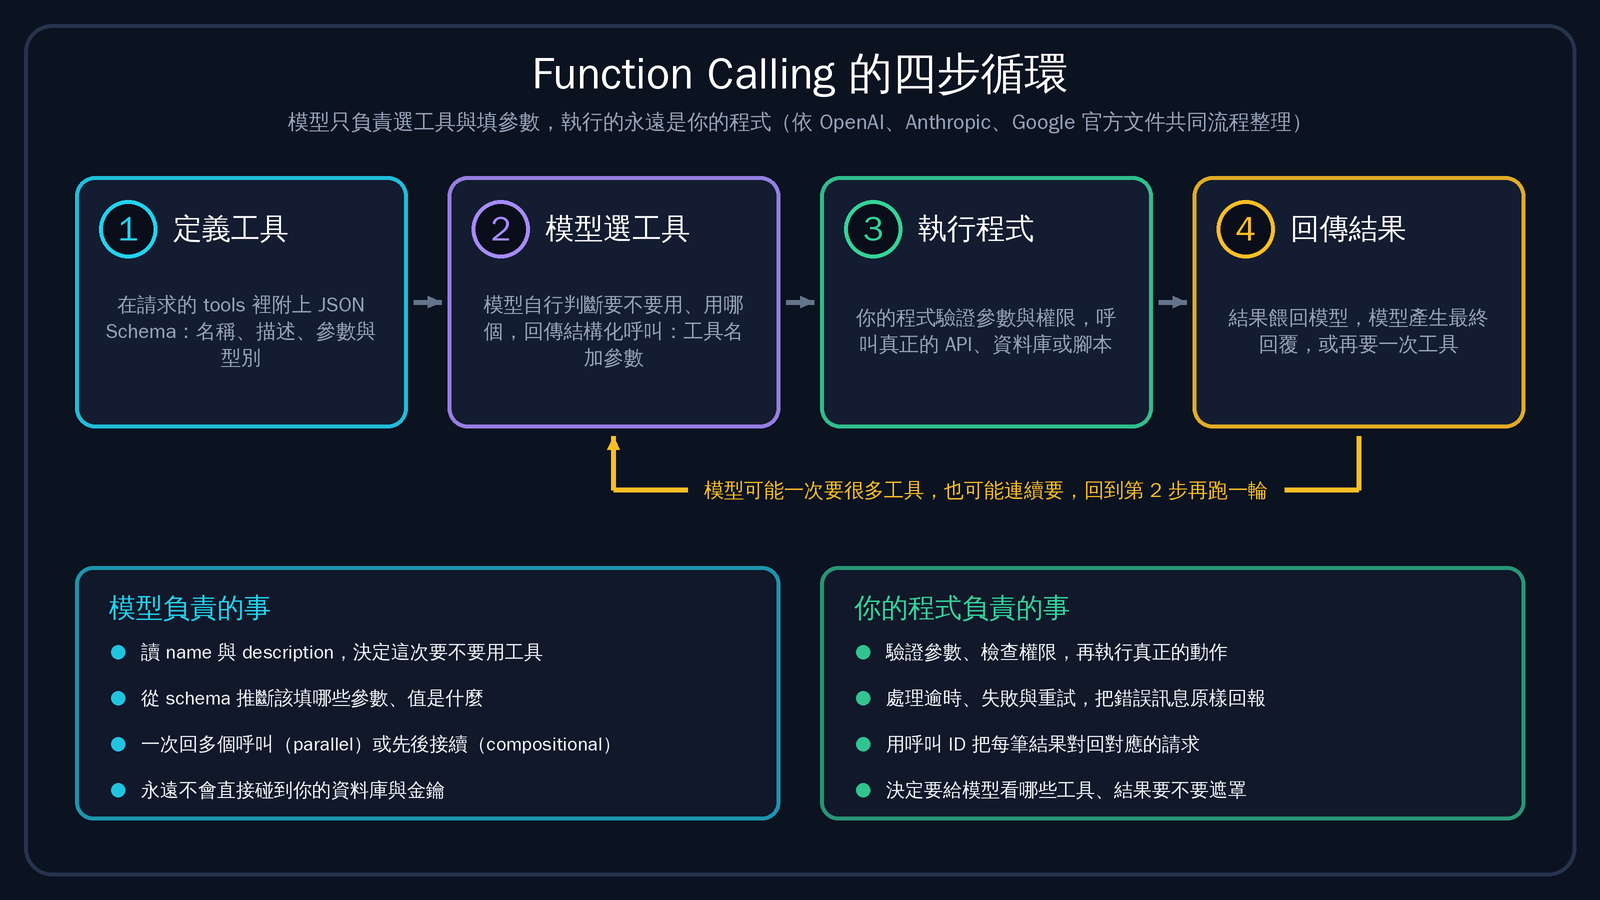
把上圖的循環拆成文字,就是這四步:
- 定義工具並送出請求:在 API 請求的 tools 參數裡附上函式定義,包含 name、description 與 parameters 的 JSON Schema。
- 模型選擇工具並回傳結構化呼叫:模型判斷需要哪些工具,回傳工具名稱與參數。它可能一次回一個,也可能一次回好幾個。
- 你的程式執行:驗證參數與權限,呼叫真正的 API、資料庫、CLI 或內部服務,並處理失敗與逾時。
- 把結果送回模型:帶著對應的呼叫 ID 把結果餵回對話,模型產生最終回覆;如果還需要更多資訊,它會再要一次工具。
第 2 步到第 4 步會重複很多次。OpenAI 的文件把整件事寫成五個高階步驟(送出帶工具的請求、收到工具呼叫、執行程式、再送一次請求帶上工具輸出、收到最終回覆或更多工具呼叫),本質上和上面是同一個循環,只是把「定義工具」獨立成一步。判斷迴圈要不要繼續的,永遠是你的程式,不是模型。
工具定義就是一張 JSON Schema
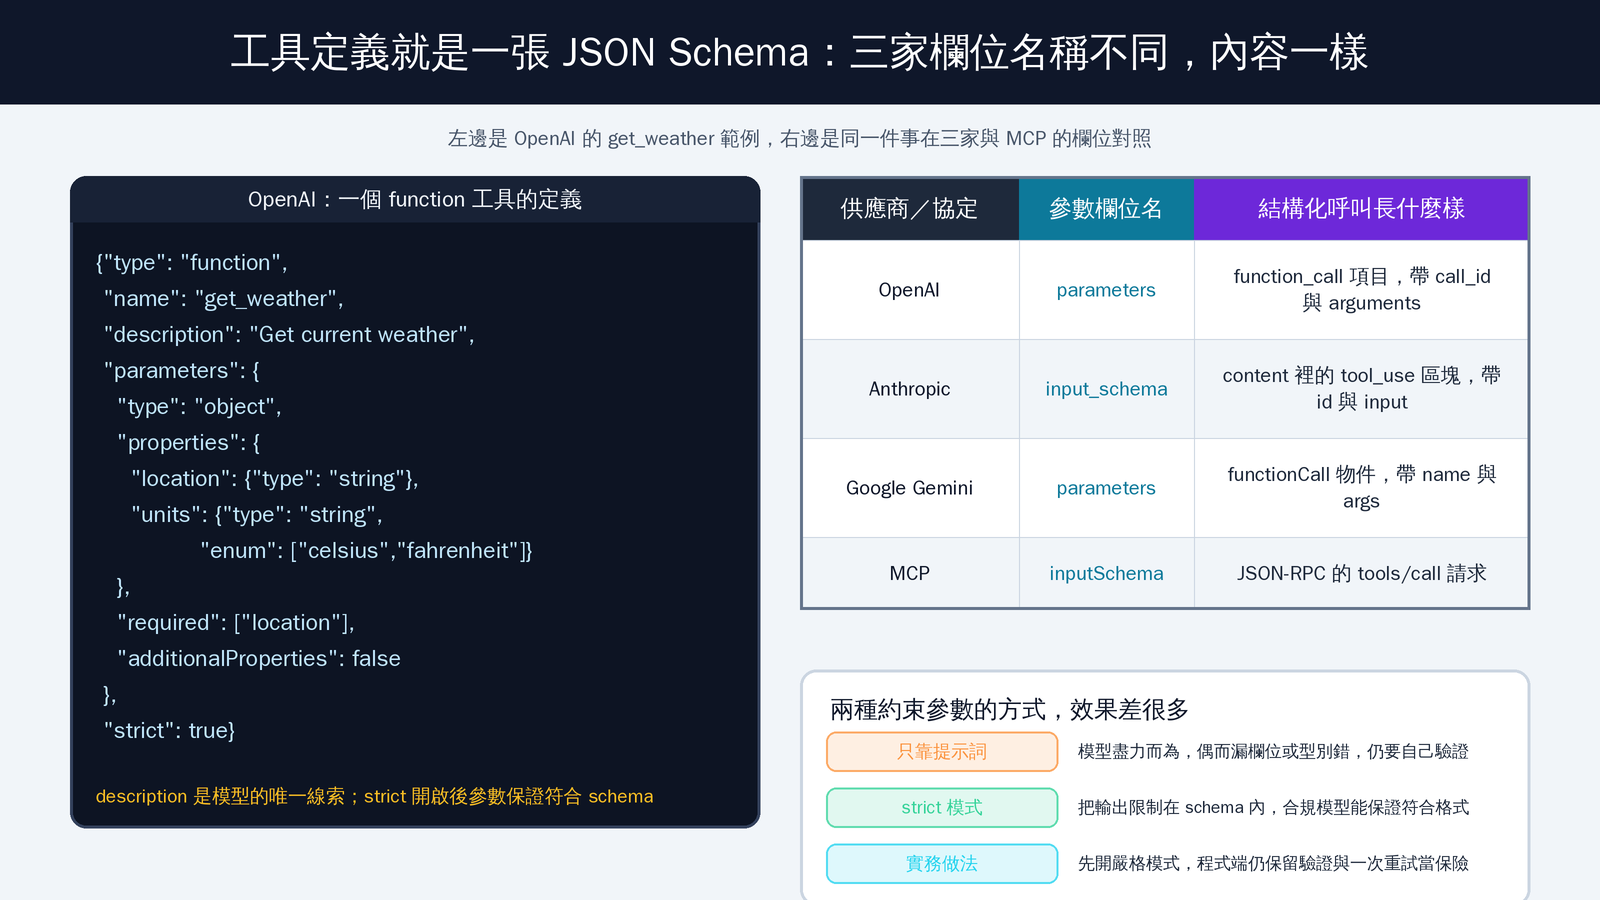
工具定義的品質幾乎決定成敗,因為模型唯一的線索就是 name 與 description。OpenAI 的函式定義欄位固定是這幾個:type 一律填 function、name、description 用來描述何時與如何使用、parameters 是輸入參數的 JSON Schema、strict 決定是否嚴格遵守 schema。
{
  "type": "function",
  "name": "get_weather",
  "description": "查詢指定城市目前的天氣,使用者問氣溫、降雨或要不要帶傘時使用。",
  "parameters": {
    "type": "object",
    "properties": {
      "location": {
        "type": "string",
        "description": "城市與國家,例如 Taipei, Taiwan"
      },
      "units": {
        "type": "string",
        "enum": ["celsius", "fahrenheit"],
        "description": "回傳的溫度單位"
      }
    },
    "required": ["location", "units"],
    "additionalProperties": false
  },
  "strict": true
}
幾個實務要點:
- description 要寫使用時機,不要只把工具名稱翻成白話。寫清楚「什麼情況該用、什麼情況不該用」,模型才判斷得準。
- 能用 enum 就把選項寫死。值域越窄,模型自由發揮的空間越小,錯誤就越少。
- strict 模式有額外要求:每個物件都要 additionalProperties: false,而且 properties 裡的欄位必須全部列進 required。真的想留選填欄位,就把 null 加進型別選項。
- 寧可多給一個查詢工具,也不要試著把一大堆資料塞進系統提示。讓模型自己決定什麼時候去查,通常又準又便宜。
Python 實作:一個能跑的最小迴圈
下面是一個最小可執行的版本。這裡用 OpenAI Chat Completions 風格的欄位,換成 Anthropic 或 Gemini 時把欄位名稱換掉,迴圈邏輯完全一樣。
import json
from openai import OpenAI

client = OpenAI()  # 讀取環境變數中的 API 金鑰

tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "查詢指定城市目前的天氣,使用者問氣溫、降雨或要不要帶傘時使用。",
    "parameters": {
        "type": "object",
        "properties": {
            "location": {"type": "string", "description": "城市與國家,例如 Taipei, Taiwan"},
            "units": {"type": "string", "enum": ["celsius", "fahrenheit"]},
        },
        "required": ["location", "units"],
        "additionalProperties": False,
    },
    "strict": True,
}]


def get_weather(location, units="celsius"):
    """換成你真正的 API 或資料庫查詢。"""
    return {"location": location, "temp": 27, "units": units, "sky": "多雲"}


def ask(prompt, max_rounds=3):
    messages = [{"role": "user", "content": prompt}]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="gpt-4o-mini",          # 換成你帳號可用的模型名稱
            messages=messages,
            tools=tools,
            tool_choice="auto",
        )
        msg = resp.choices[0].message
        messages.append(msg)

        if not msg.tool_calls:            # 沒有工具呼叫就是最終答案
            return msg.content

        for call in msg.tool_calls:
            try:
                args = json.loads(call.function.arguments)
                if call.function.name == "get_weather":
                    result = get_weather(**args)
                else:
                    result = {"error": "unknown tool: " + call.function.name}
            except Exception as exc:
                result = {"error": str(exc)}   # 錯誤原樣回報,不要吞掉
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,            # 一定要對回呼叫 ID
                "content": json.dumps(result, ensure_ascii=False),
            })
    return "已達工具呼叫次數上限,請縮小問題範圍"


print(ask("台北現在幾度?"))
這段程式有四個地方一定要做對:
- 回傳結果要帶上對應的呼叫 ID。OpenAI 是 tool_call_id,Anthropic 是 tool_use_id。少了它,API 會直接拒絕你的請求。
- 工具失敗不要吞掉。把錯誤字串原樣回傳,模型才有機會換個參數或改用別的工具重試。
- 迴圈一定要有上限。max_rounds 就是預算上限,沒有它,模型反覆呼叫同一個工具會把你的額度燒完。
- tool_choice 決定模型能不能選擇不用工具。設 auto 是讓模型自己判斷,設 required 則強制它至少用一個。
Function Calling 與 MCP 的關係:機制與部署方式的差別
這是 2026 年最常被問的問題,而答案是:兩者不在同一個層次,也不是替代關係。function calling 屬於模型 API 的能力,負責回答「模型用什麼格式表達它想呼叫哪個工具、要帶什麼參數」;MCP(Model Context Protocol)是應用層的客戶端與伺服器協定,負責回答「工具怎麼被封裝、被發現、被呼叫與被授權」。
換句話說,MCP 用的是 function calling,而不是取代它。MCP 客戶端連上伺服器後,先用 tools/list 問「你有哪些工具」,把拿回來的 JSON Schema 當成函式定義餵給模型;模型照樣用它原生的 function calling 決定要用哪一個;客戶端再把這個呼叫轉成 tools/call,送到當初註冊該工具的伺服器。模型端完全不需要知道 MCP 的存在。完整流程大致是這樣:
- MCP 伺服器發布工具(可選的還有資源與提示範本)
- MCP 客戶端列出並過濾工具,套用允許清單與使用者授權
- 主程式把選中的工具轉成模型供應商的函式定義格式
- 模型回傳函式呼叫(名稱與參數)
- 客戶端解析名稱,呼叫對應伺服器的 tools/call
- 伺服器操作真正的 API、資料庫、CLI 或 SDK
- 結果轉回模型的工具輸出格式,繼續推理或收斂成答案
該不該上 MCP,判斷方式很簡單:工具只給這一個應用程式用、數量在十個以內,直接用 function calling 最省事;工具要跨多個客戶端共用、需要伺服器端統一處理權限與審計、或由別的團隊提供,才值得多一層 MCP。它的傳輸(本機用 stdio,遠端用 Streamable HTTP)與三層架構,MCP 圖解入門:Model Context Protocol 怎麼把 AI 工具接起來(2026)寫得很完整。
平行呼叫、tool_choice 與 structured outputs:三個常用開關
工具定義好之後,控制模型「要不要用工具、能不能一次用很多個、輸出格式要多嚴格」,靠的是三個開關。第一個是工具選擇策略:
| tool_choice 的值 | 行為 |
|---|---|
| none | 完全停用工具,模型只能用文字回答 |
| auto | 由模型決定要不要用、要用哪一個,這是預設值 |
| required | 強制模型至少使用一個工具,但用哪一個由模型挑 |
| 指定工具 | 直接指定工具名稱,強制模型只能用這一個(Anthropic 寫成 tool,Gemini 依 API 版本而異) |
第二個是平行呼叫。OpenAI 用 parallel_tool_calls 控制,設成 false 時一次最多回傳一個呼叫;Anthropic 的平行工具使用預設就是開啟的,要關掉得在 tool_choice 物件裡設 disable_parallel_tool_use: true,注意它不是頂層參數。平行呼叫的效益是省下好幾次來回,代價是結果必須全部對回各自的呼叫 ID,漏掉一個就會被 API 打回。
第三個是把輸出限縮在 schema 內。OpenAI 的 Structured Outputs 有兩種用法,官方文件建議這樣選:
| 情境 | 該用什麼 | 怎麼設 |
|---|---|---|
| 要接工具、讓模型執行動作 | function calling 加 strict | 在函式定義裡設 strict: true |
| 要模型用特定結構直接回覆使用者 | 結構化輸出(response_format 或 text.format) | 指定 json_schema 並開啟嚴格模式 |
這裡要順手釐清兩個常見誤解。第一,JSON 模式只保證回傳的是合法 JSON,不保證欄位與型別符合你指定的 schema;要保證符合,得用 Structured Outputs,不然就得自己在程式端驗證並重試。第二,OpenAI 早期的官方說明曾提到 Structured Outputs 與平行函式呼叫不相容,需要用平行呼叫時請把它關掉;各家對這個組合的支援仍在演進,實際使用請以官網文件為準。
常見五種錯誤與重試策略
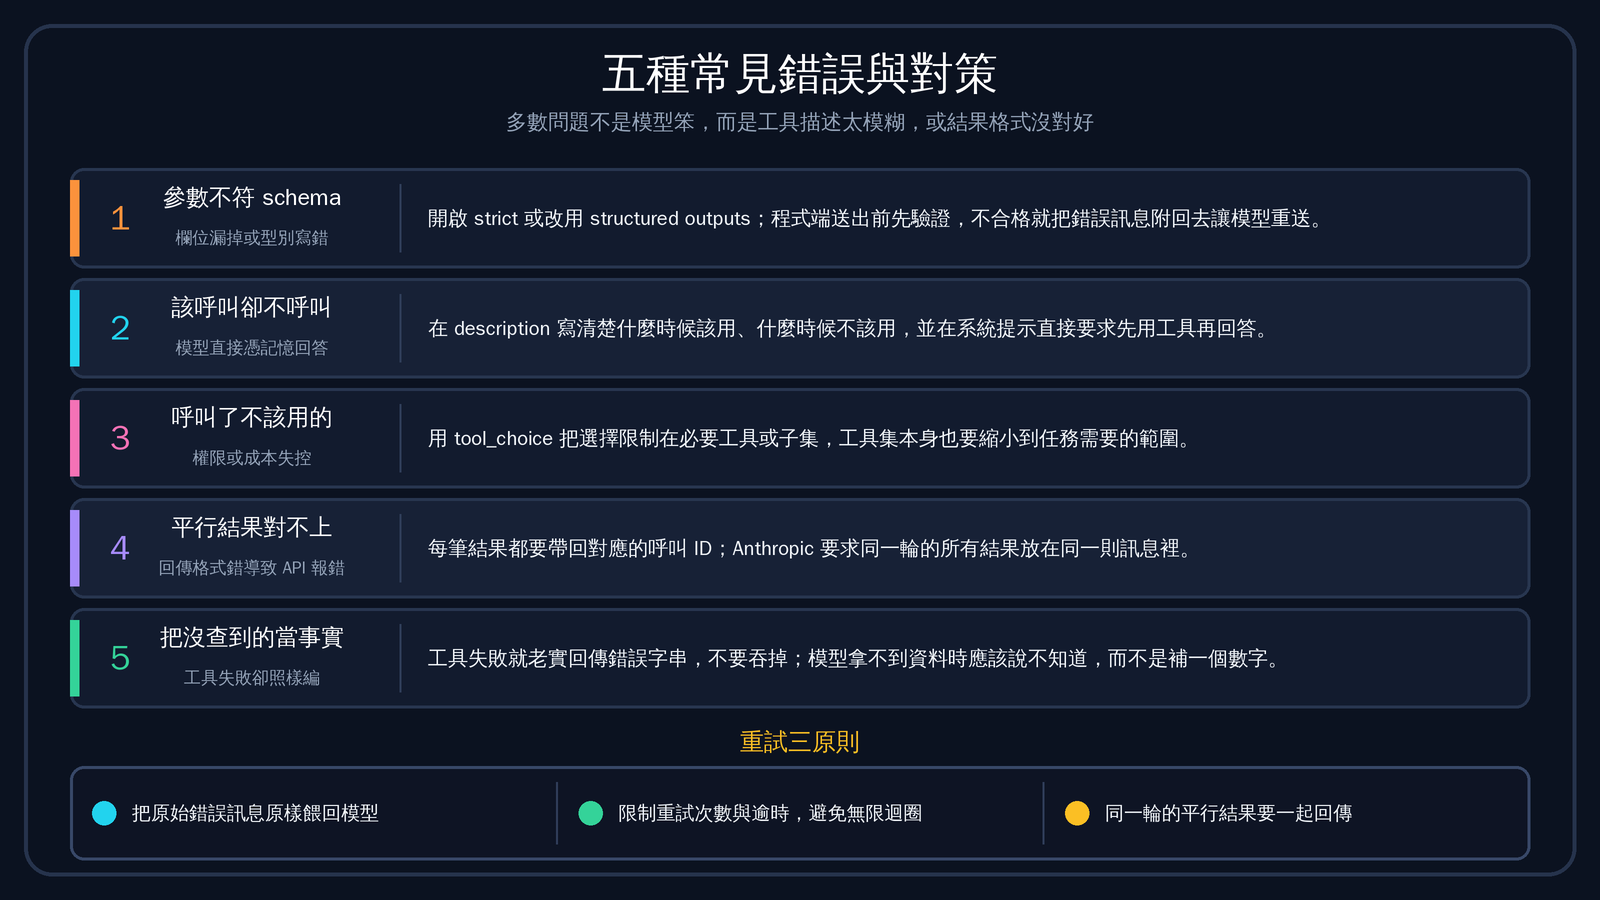
把前面幾節會踩到的坑整理成一張對照表:
| 症狀 | 常見原因 | 對策 |
|---|---|---|
| 參數少欄位或型別寫錯 | description 太模糊、schema 限制不足 | 開啟 strict 模式,程式端仍要驗證並允許一次重試 |
| 該查資料卻直接憑記憶作答 | 系統提示沒要求,description 沒寫使用時機 | 在系統提示明確要求先查再答,並補上觸發條件 |
| 呼叫了不該用的工具 | 一次掛上太多工具、權限沒收斂 | 用 tool_choice 限制選擇範圍,依任務只掛必要工具 |
| 平行呼叫的回傳被拒絕 | 結果沒對回呼叫 ID、或不同輪結果混在一起 | 每筆結果都帶 call_id 或 tool_use_id,同一輪的一起送出 |
| 把幻覺當事實講出來 | 工具失敗被吞掉,模型只好自己想辦法補 | 錯誤原樣回報,並要求資料不足時坦白說明 |
重試其實只有三個原則:把原始錯誤訊息原樣餵回模型,不要只回「失敗」兩個字;限制重試次數與逾時,避免無限迴圈把預算燒光;同一輪的平行呼叫結果要一起回傳,缺一個就整批失敗。這三點做到了,多數 function calling 的穩定性問題就消失大半。
常見問答
Function calling 需要模型有特殊訓練嗎?
需要。工具呼叫是模型在訓練階段就得學會的能力,所以不是每個模型都支援,平行工具呼叫更只有部分模型支援。OpenAI 早期是從特定的模型版本開始支援,現在的多數模型都已經具備,挑模型前請看官方文件的支援清單。
模型會不會自己執行程式碼?
不會。模型只回傳結構化的呼叫請求,執行的是你的程式。這也是為什麼參數驗證、權限檢查、金流與資料遮罩都必須寫在應用程式端。把「模型呼叫了函式」當成「模型執行了函式」,是很危險的誤解。
description 到底要寫多長?
不嫌長,但要具體。官方文件反覆強調 description 是模型的判斷依據。與其寫「查天氣」,不如寫「查詢指定城市目前的天氣,使用者問氣溫、降雨或要不要帶傘時使用」。多寫一句觸發條件,往往比調參數有效。
為什麼模型有時一次回傳好幾個工具呼叫?
當多個呼叫之間沒有依賴關係時,模型會改成並行請求以省下來回次數,例如同時查三個城市的天氣。若第二個呼叫必須用到第一個的結果,模型就會退回序列式,一步一步來。
Function calling 跟 RAG 要選哪一個?
兩者解決不同問題。RAG 是把外部知識檢索進上下文,function calling 是讓模型能夠執行動作。實務上最好的系統通常兩者都有:把檢索包成一個工具,由模型決定什麼時候去查。這個組合的做法可以看 RAG 檢索增強生成圖解教學:讓 AI 回答查得到根據(2026)。
想壓低成本,該從哪裡下手?
工具掛越多,每一輪請求要帶的輸入 token 就越多,而這個迴圈每跑一輪就會重送一次完整歷史。把工具集縮小到任務真正需要的範圍,同時是最直接的成本控制與準確度控制。訂閱制與 API 計費的差異,AI 訂閱費怎麼算?2026 主流 AI 訂閱與 API 計費圖解對照有完整對照。
延伸閱讀
- 大模型是什麼?2026 最新白話入門與選型重點
- 大模型 API 怎麼挑?價格、上下文、工具呼叫比較(2026)
- MCP 圖解入門:Model Context Protocol 怎麼把 AI 工具接起來(2026)
- AI 訂閱費怎麼算?2026 主流 AI 訂閱與 API 計費圖解對照
- AI 編程工具怎麼選?Claude Code、Codex、Cursor、Gemini CLI 四強比較(2026)
- RAG 檢索增強生成圖解教學:讓 AI 回答查得到根據(2026)
本文內容對照 OpenAI 的 function calling 指南與 Structured Outputs 說明、Anthropic 的 tool use 與 parallel tool use 文件、Google Gemini 的 function calling 文件,以及 Model Context Protocol 的規格文件整理,查證日期 2026-10-19。各家的支援模型清單與參數名稱會隨版本調整,實際使用請以官網文件為準。